Was 70 GenAI-Projekte lehren
Erfolgsfaktoren für KI-Projekte
Der GenAI Zürich Award 2026 hat in diesem Jahr fast 70 Einreichungen aus der Schweiz und Europa erhalten, von Fünf-Personen-Startups bis zu Grossunternehmen. Die Bandbreite reichte quer durch das Gesundheitswesen, Versicherungen, Landwirtschaft, Industrie und Bildung. 15 unabhängige Branchenexperten aus den Bereichen KI, Cloud-Infrastruktur, Venture Capital und Unternehmenstechnologie haben jedes einzelne Projekt bewertet, die Gewinner wurden Anfang April in Zürich gekürt. Bewertet wurden die Einreichungen in drei Kategorien, Rising Innovators, Impact Achievers und Enterprise Transformers.
Das eigentlich Interessante an diesem Jahrgang kam aber erst danach. Die Jury hat den kompletten Datensatz, jede Einreichung, jede Expertenbewertung und jedes Stück Jury-Feedback im Anschluss noch einmal systematisch ausgewertet. Das Werkzeug dafür war das agentische KI-Tool Kiro von AWS, gesteuert über eigens definierte Strands Agent SOPs. Herausgekommen sind zwei praktische Leitfäden, einer für Business-Entscheider, einer für Ingenieure und Architekten. Sie zeigen, was die stärksten der fast 70 Projekte tatsächlich richtig gemacht haben.
Analyse als eigenes Experiment
Die Auswertung selbst ist dabei fast so aufschlussreich wie ihr Ergebnis. Als Orchestrierungsumgebung diente Kiro CLI. Darauf aufbauend definierten eigens geschriebene Strands Agent SOPs, Standard Operating Procedures aus dem Open-Source-Projekt Strands Agents, den kompletten Ablauf: das Einlesen der Einreichungen und Expertenbewertungen, den Abgleich mit dem Feedback der Jury, das Erkennen wiederkehrender Muster und schliesslich das Verfassen der fertigen Texte. Als Sprachmodell kam Claude Opus 4.6 von Anthropic zum Einsatz.
Der Prozess folgte denselben Prinzipien, die sich auch in den stärksten der bewerteten Projekte zeigten. Jede SOP übernahm nur eine einzige Aufgabe, Dateneinlese, Mustererkennung oder Guide-Erstellung liefen als getrennte Schritte statt als ein einziger, alles versuchender Prompt. Jury-Mitglieder prüften und kommentierten jede Zwischenversion, ihr Feedback floss direkt in die nächste Iteration ein. Der Business-Guide entstand zuerst und diente anschliessend als Referenz für den Technical Guide, damit beide Dokumente dieselbe Begrifflichkeit und dieselben Beispiele nutzen. Am Ende standen zwei Leitfäden mit zusammen über 7000 Wörtern Analyse, basierend auf bewerteten Einreichungsdaten und erzeugt über einen Workflow, den jedes Team für eigene Auswertungsprojekte nachbauen könnte. Die SOPs selbst durchliefen dabei mehrere Runden. Frühe Versionen lieferten Text, der zu berichtsartig war zu lang, oder versehentlich identifizierende Details preisgab. Jede Expertenrunde deckte neue Schwachstellen auf, aus denen wiederum neue Vorgaben wurden, bis die Ergebnisse mit jeder Iteration klarer und knapper wurden.
Der Nachweis
Der grösste Stolperstein war laut Jury nicht technischer Natur, sondern ein Nachweisproblem. Über 75 Prozent der eingereichten Projekte konnten ihren Business-Impact nicht belegen. Die Technologie funktionierte, nur die Messinfrastruktur dazu fehlte. Gutachter bemängelten immer wieder Behauptungen ohne Methodik und Wirkungszahlen, die sich als Projektion statt als Messung entpuppten. Selbst technisch beeindruckende Projekte taten sich schwer, weitere Investitionen zu sichern, wenn sie ihren Wert nicht in Geschäftszahlen ausdrücken konnten.
Wie sich diese Lücke schliessen lässt, belegen zwei Projekte aus dem Datensatz. Ein Digital-Marketing-Unternehmen konzentrierte sich ausschliesslich auf bessere Akquise-E-Mails für Vertriebsteams, und belegte innerhalb von drei Monaten einen Umsatzanstieg von 25 Prozent bei dreimal günstigerem Betrieb. Ein Healthcare-Startup ging denselben Weg bei der klinischen Dokumentation. Es fokussierte sich auf die administrative Last, die Ärzten am meisten zu schaffen macht. Nach 16 Monaten hatte es 45 zahlende Kunden im Gesundheitswesen, über 300 aktive Nutzer und einen konkreten Spitaleinsatz.
Vier Fragen vor dem Start
Laut einer Anthropic-Analyse von 100'000 realen Konversationen mit Claude beschleunigt generative KI einzelne Aufgaben um durchschnittlich 80 Prozent. Hochgerechnet auf die Gesamtwirtschaft entspricht das einer Verdopplung des jährlichen Produktivitätswachstums. Organisationen, die früh tief einsteigen, bauen damit einen Vorsprung auf, den Nachzügler kaum noch aufholen können.
Ein Grosskonzern aus der Konsumgüterbranche zeigt, wie sich das auch im grossen Massstab umsetzen lässt. Er rollte seinen KI-Assistenten in über hundert Märkten aus und verfolgte die Nutzung so konsequent, dass er am Ende über 90 Prozent Adoptionsrate und konkret gemessene Zeitersparnis pro Mitarbeiter und Woche vorweisen konnte. Der Unterschied zu den vielen Projekten ohne Nachweis lag nicht in der Technologie, sondern in der Entscheidung, Messung von Anfang an mitzudenken. Die Jury leitet daraus eine klare Regel ab: Wer ernsthaft in generative KI investiert, sollte vier Fragen beantworten können, bevor überhaupt eine Zeile Code geschrieben wird. Wird das System tatsächlich genutzt? Wie viel Zeit spart es? Sind die Ergebnisse gut genug, um ihnen zu vertrauen? Und was kostet eine Arbeitseinheit im Vergleich zur bisherigen Lösung? Wer sein System von Beginn an so aufbaut, dass sich Nutzung, Effizienz, Qualität und Kosten automatisch erfassen lassen, hat die Zahlen zur Hand, sobald die Frage nach dem Wert der Investition gestellt wird.
Vierschichtiger Architektur-Stack der stärksten Projekte: Die Auswertungs-infrastruktur zuunterst war zugleich die häufigste Lücke im gesamten Datensatz.
AWS Schweiz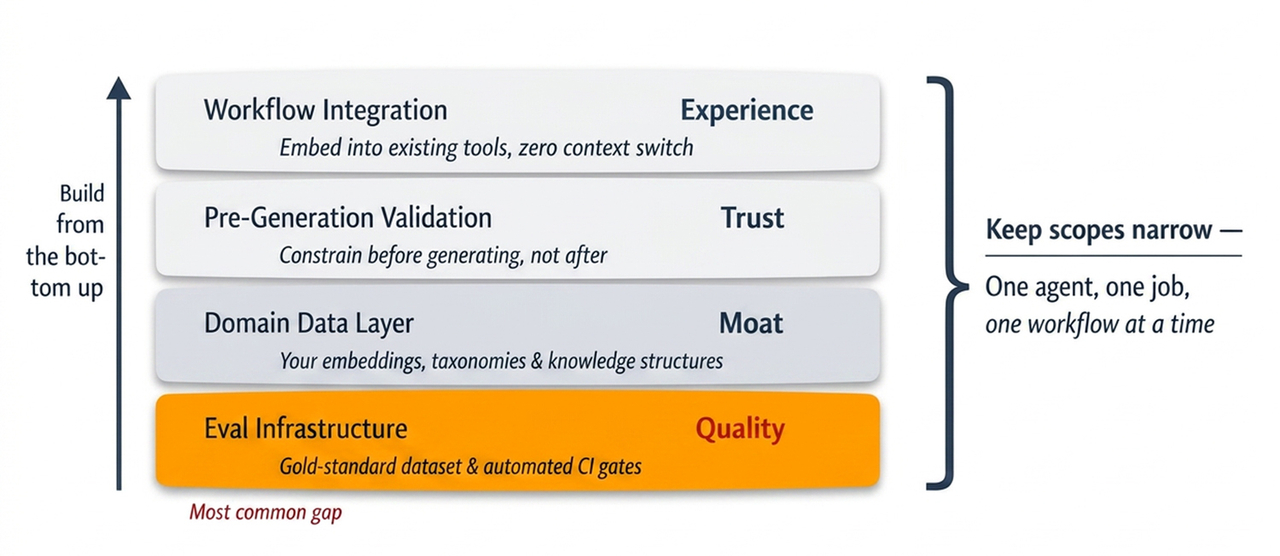
Regeln schaffen Vertrauen
Eine zweite Erkenntnis überrascht auf den ersten Blick. Governance bremst die Einführung von generativer KI nicht, sie beschleunigt sie. Projekte mit sauberer Compliance nach dem Schweizer Datenschutzgesetz und lückenlosen Audit-Trails erhielten schneller interne Freigabe als Projekte ohne diese Grundlage. Eine Versicherung, die juristische Fälle bearbeitet, baute DSG-Konformität, nachvollziehbare Outputs, laufendes Drift-Monitoring und die verpflichtende menschliche Prüfung jeder KI-generierten Fallzusammenfassung von Anfang an in ihr System ein. Was auf den ersten Blick wie zusätzlicher Aufwand aussah, wurde intern zum Verkaufsargument und beschleunigte die Einführung, statt sie zu verzögern.
Ein Pharmaunternehmen ging einen ähnlichen Weg bei einem KI-gestützten Patientensupport-System. Die klinische Sicherheitsschicht überwacht dort jede Interaktion in Echtzeit und kann eingreifen, bevor eine unpassende Aussage den Patienten erreicht. In der klinischen Studie dazu waren die Rückmeldungen durchweg positiv, medizinisches Fachpersonal berichtete, die KI habe die Betreuung ergänzt statt ersetzt. Einen leicht anderen Ansatz wählte eine Plattform aus dem öffentlichen Sektor: Generative KI übernimmt dort bewusst nur eine unterstützende Rolle, rechtsverbindliche Entscheidungen bleiben einer transparenten, regelbasierten Logik vorbehalten. Auch das ist Governance als Gestaltungsprinzip und nicht als nachträgliche Einschränkung. Governance-Dokumentation gehörte an den Anfang eines jeden Projekts, nicht an dessen Ende. Ein Datenflussdiagramm, eine Aufbewahrungsrichtlinie und ein Audit-Trail sind an einem Tag erstellt, ersparen aber Monate an Diskussionen mit Stakeholdern später im Prozess.
Domänenwissen schlägt Modell-Updates
Die dritte Erkenntnis betrifft die Architektur selbst. Die grössten Genauigkeitssprünge kamen nicht aus einem besseren Foundation-Modell, sondern aus firmenspezifischen Datenschichten. Ein Unternehmen aus der Onkologie-Diagnostik trainierte eigene Encoder für Pathologie, Radiologie und Genomik von Grund auf. Damit erreichte es Bestwerte bei der Erkennung in der Pathologie, und das mit hundertmal weniger Trainingsdaten als vergleichbare Ansätze.
Die Jury zog daraus den allgemeinen Schluss: Das Sprachmodell sollte austauschbar bleiben, entscheidend ist die Datenschicht darunter. Generische Modellfähigkeiten waren in nahezu allen ausgezeichneten Projekten längst Standard. Den Unterschied machte, wer zusätzlich eine strukturierte Wissensschicht aufbaute, die kein Konkurrent einfach kopieren konnte. Diese Schicht, nicht das Modell darüber, war laut Jury der eigentliche Wettbewerbsvorteil.
Vorsprung durch die eigenen Daten
Wie stark dieser Effekt ausfallen kann, belegt eine Plattform für industrielles Sourcing. Sie musste Anfragen von Einkäufern mit den Fähigkeiten hunderttausender Lieferanten abgleichen, generische semantische Suche lieferte dafür zu viel Rauschen. Das Team trainierte stattdessen eigene Embeddings auf Basis industrieller Teile-Taxonomien und steigerte die Trefferquote von 25 auf 70 Prozent, validiert über mehrere Pilotprojekte hinweg. Ein zweites Beispiel bestätigt das Muster aus einer ganz anderen Branche. Ein Startup für stimmbasiertes Gesundheitsscreening baute seine Datengrundlage aus über einer Million Sprachprüfungen auf. Es war robust genug, um über mehr als 25 Krankheitsbilder hinweg zu funktionieren, mit sprachunabhängigen akustischen Merkmalen, die über verschiedene Sprachen hinweg generalisieren. Abgesichert wurde das Ganze durch eigene Patente und eine CE-Zertifizierung als Medizinprodukt. Den Gegensatz dazu lieferten Teams, die lediglich bestehende APIs verketteten, ohne eigene Datenschicht oder Domänentraining. Auf die Frage, was an ihrer Lösung noch KI-spezifisch sei im Vergleich zu klassischen Empfehlungsalgorithmen, blieben viele eine klare Antwort schuldig. Aus solchen Beispielen leitet der technische Leitfaden eine Faustregel ab: Produktive Systeme mit generativer KI bestehen zu rund 20 Prozent aus dem Modell selbst und zu 80 Prozent aus allem, was darum herum gebaut wird. Dazu gehören Datenpipelines, Terminologie-Schichten, Feedback-Schleifen, Monitoring und die Integration in bestehende Arbeitsabläufe. Wer zuerst die Datenschicht seiner Domäne aufbaut und erst danach ein Foundation-Modell auswählt, folgt damit demselben Muster wie die stärksten Projekte im gesamten Datensatz.
Erkenntnisse aus fast 70 GenAI-Projekten aus der Schweiz und Europa: Erfolgsmuster der stärksten Einreichungen und die häufigsten offenen Lücken.
AWS Schweiz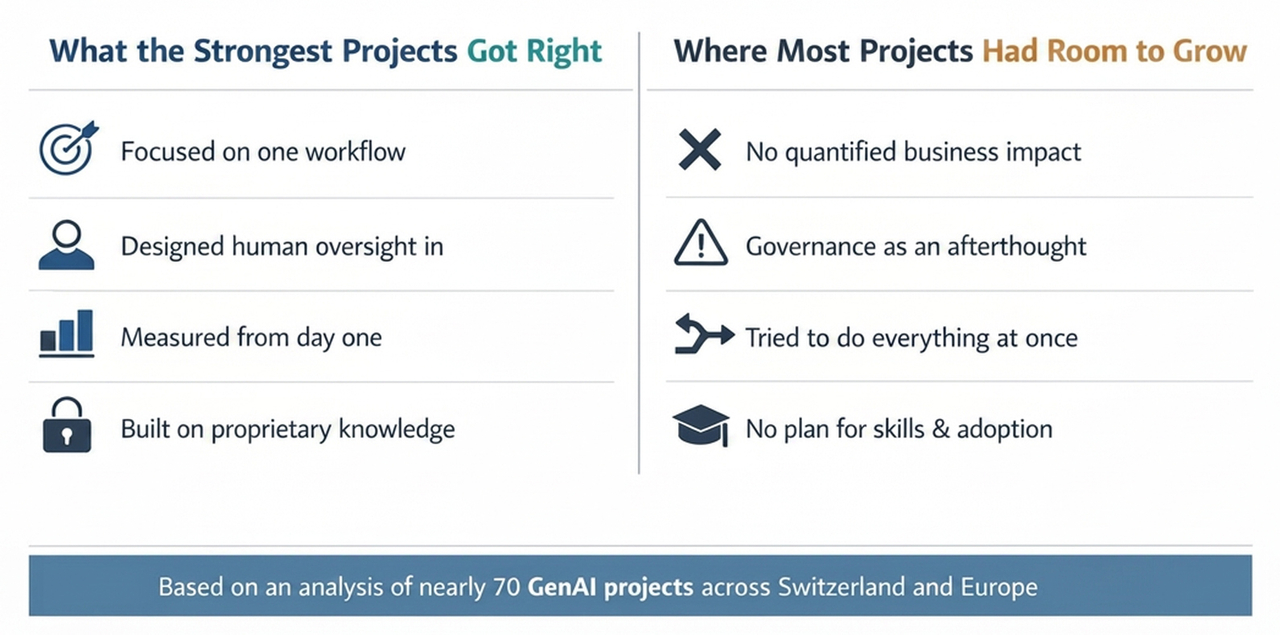
Kontrolle vor der Reaktion
Ein Muster aus den technisch stärksten Projekten in regulierten Branchen fiel der Jury besonders auf: Sie prüften Ergebnisse, bevor das Modell überhaupt etwas generierte, nicht erst hinterher. Eine Versicherung, die mehrsprachige Fachübersetzungen für den Konzern produziert, baute dafür eine deterministische Terminologie-Schicht. Eingaben werden per Fuzzy-Matching mit einer kuratierten Datenbank abgeglichen, verbindliche Rechts- und Markenbegriffe werden fixiert, bevor das Sprachmodell überhaupt zu schreiben beginnt. Das Modell arbeitet danach innerhalb eines gestuften Kontrollgraphen aus Formulieren, Prüfen und Erklären, mit klaren Grenzen bei jedem Schritt. Das Ergebnis waren tausende produktive Anfragen, Antwortzeiten unter zehn Sekunden und nahezu fehlerfreie Trefferquoten. Der entscheidende Unterschied zu klassischer Fehlerkorrektur danach ist simpel: Nachträgliche Filter fangen Fehler ab, eine Validierung vor der Generierung verhindert sie von vornherein.
Weitere Erkenntnisse
Bei Multi-Agenten-Systemen zeigte sich ein ähnlich klares Bild: Erfolgreich waren jene Projekte, die den Aufgabenbereich jedes einzelnen Agenten eng hielten. Eine Plattform für Agrarmarketing setzte fünf spezialisierte Agenten ein, je einen für Orchestrierung, Recherche, Planung, Content-Erstellung und Auswertung, verbunden mit Live-Marketingdaten über das Model Context Protocol. Innerhalb weniger Monate nach dem ersten funktionsfähigen Prototyp lief das System produktiv in über zehn Märkten auf vier Kontinenten. Ein Assistent für eine grosse ERP-Migration ging einen anderen Weg: Ein sogenannter Pathfinder-Agent liest per Vision-Modell in Echtzeit mit, was Nutzer gerade auf dem Bildschirm sehen, und führt sie Schritt für Schritt durch komplexe Oberflächen. Am Tag der Inbetriebnahme zählte das System über 1100 einzelne Nutzer, mehr als 3000 Interaktionen in Echtzeit und über 100 Millionen verarbeitete Tokens. In beiden Fällen hatte jeder Agent genau eine Aufgabe und ein übergeordneter Orchestrator verteilte die Arbeit. Eine technische Lücke zog sich durch einen Grossteil des Datensatzes: fehlende Auswertungsinfrastruktur. Den meisten Projekten fehlte eine automatisierte Methode, um zu prüfen, ob ihre Ergebnisse korrekt, konsistent oder überhaupt besser wurden. Die Gegenprobe lieferte eine Übersetzungsplattform, die ihr System in einer verdeckten Prüfung von professionellen Übersetzern gegen den Marktführer antreten liess, Segment für Segment, über mehrere Sprachpaare hinweg. Das Ergebnis, fast doppelt so viele als perfekt bewertete Übersetzungen, wurde zum Kernstück ihrer Vertriebsargumentation gegenüber Unternehmenskunden.
Fazit
Die Technologie ist so weit. Fast 70 Projekte belegen das über alle Branchen hinweg. Die Frage lautet, ob ein Unternehmen seinen Nutzen auch beweisen kann, die Nutzung verantwortungsvoll steuert und lange genug bei einer Aufgabe bleibt, um daraus echten Wert zu ziehen. Viele Teams bauten technisch überzeugende Systeme, ohne Schulung oder Change-Management von Anfang an mitzudenken. Die Fähigkeit, KI zu beaufsichtigen, zu steuern und sinnvoll einzusetzen, wird zunehmend so wichtig wie klassische digitale Kompetenz. Ein technisch ausgereiftes System nützt wenig, wenn im Unternehmen niemand gelernt hat, es auch zu nutzen. Teams, die nur eine einzelne Aufgabe automatisierten, erzielten lineare Verbesserungen. Teams, die mit generativer KI ganze Arbeitsabläufe neu dachten, etwa einen sequenziellen Prüfprozess in einen parallelen umwandelten, machten sprunghafte Fortschritte.
Der Autor
Christoph Schnidrig ist Head of Technology bei AWS Schweiz und bringt über 25 Jahre Erfahrung in Cloud, Storage und IT-Sicherheit mit.